2025/10/02 Omotesando.rb メモ
mruby型検査
感想
- mrubyがあまりわからないが、仕様が小さいところから始めるというのは納得感あった
管理画面のフロントエンド
- Vue
- 読みやすく開発体験は悪くない
- 管理画面にVueを混入させたくないという意向
- Hotwire
- ユーザー向けはReact
- Hotwire
- 結構古いJSの記述
- 採用は厳しい
感想
- Hotwire触ってみたい
- 似たような問題はどこでもぶつかる
- 現職でも管理画面にVueはあるが、更新に手が回らずリプレイス対象となっている
Concerns再考
- Concern好きじゃない
- Before Concernは難しい
- After Concernはすっきりした
- Fat modelはConcernによって解決できるかは曖昧
- コードは分割するが責務はそうでもないかも
- privateメソッドもincludeするので責務も巻き込むのでは?
- AttachableやSearchableは個人の経験に依存しているのでわかりづらいのでは?
- ちゃんと汎用的に作ろう
感想
- Concernはあまり使いたくないな
- 横断的な関心に特化すべきだけど特定の用途に限定されているケースが多いと、委譲や合成でいいのではと思っている
- 共通化・抽象化が難しいのは同意
本番環境で安全にmigration
- mysql8系でchange column typeもオンラインでいけるらしい
- 安全ではない
- AddCheckConstraint
- メタデータロック
- RemoveColumn
- ignore_columnが必要
- 知らない人が踏んでしまう
- strong_migrations gem
- 全部が回避できるではない
- exampleがあるので参考にすればいい
感想
- 身に覚えがありすぎる
- 現職で直近に同様のインシデントがあり、strong_migrationsは検討にあがっていた
- 誰かがstrong_migrationsあまり入れたくないと言っていて理由が気になった
【React】ドラッグ&ドロップされたPNG画像を編集して表示する
目的
使用したパッケージ
- react
- react-dropzone
- pngjs
コード
- 表示する画像のデータはbase64で渡す
'use client'

import { useDropzone } from "react-dropzone"
import { PNG } from 'pngjs/browser'
import { useState } from 'react'

export default function Home() {
  const onDrop = (files) => {
    setUploadedFiles(uploadedFiles.concat(files))
    files.forEach(file => {
      const fileReader = new FileReader()
      fileReader.addEventListener('loadend', (event) => {
        const png = new PNG({filterType: 4}).parse(event.target.result, (error, image) => {
          if (error) {
            console.error(error)
            return
          }

          const newPng = new PNG({width: png.width, height: png.height})
          // newPng.dataを操作して画像を編集

          // base64にしてstateに入れる
          const base64 = PNG.sync.write(newPng).toString('base64')
          const imageData = {
            base64: base64,
            width: newPng.width,
            height: newPng.height
          }
          setImages(images.concat(imageData))
        })
      })
      fileReader.readAsArrayBuffer(file)
    })
  }

  const { getRootProps, getInputProps } = useDropzone({ onDrop })
  const [ uploadedFiles, setUploadedFiles ] = useState([])
  const [ images, setImages ] = useState([])

  const renderImage = (image, index) => {
    const dataUri = 'data:image/png;base64,' + image.base64
    const key = `image-${index}`

    return (<>
      <div key={key}>
        <Image src={dataUri} alt='' width={image.width} height={image.height} />
      </div>
    </>)
  }

  return (
    <div>
      <main>
        <div {...getRootProps()} style={{ border: "1px dashed #ff7f7f", width: 400, height: 150 }}>
          <input {...getInputProps()} />
          <p>ここにファイルをドラッグ&ドロップしてください。</p>
        </div>
        <div>
          {images.map(renderImage)}
        </div>
      </main>
    </div>
  );
}
React.js & Next.jsの勉強メモ
概要
React.js & Next.js超入門 第2版 を読んでちまちま写経していたが、 firebaseのところが現行のversion9とは結構乖離が大きくなっていたので、差分をメモしておく。 (買ってから1年以上放置してたのがそもそも悪い)

差分
初期化
書籍内
import firebase from 'firebase'

const firebaseConfig = {..}
if ( firebase.apps.length == 0) {
  firebase.initializeApp(firebaseConfig)
}
現行
import { initializeApp } from 'firebase/app';

const firebaseConfig = {...}
const app = initializeApp(firebaseConfig);
export default app;
firestoreオブジェクトの取得
書籍内
import firebase from 'firebase'

const db = firebase.firestore()
現行
import { getFirestore } from 'firebase/firestore';

const db = getFirestore(app)
ドキュメントの取得(複数)
書籍内
db.collection('mydata').get().then((snapshot) => {
  snapshot.forEach((document) => {
    const doc = document.data()
    ...
  })
})
現行
import { getFirestore, collection, getDocs } from 'firebase/firestore';

const cols = collection(db, 'mydata')
getDocs(cols).then((snapshot) => {
  snapshot.forEach((document) => {
    const doc = document.data()
    ...
  })
})
ドキュメントの取得(単一)
書籍内
import firebase from 'firebase'
import { useRouter } from 'next/router'

const router = useRouter()

if ( router.query.id != undefined ) {
  db.collection('mydata').doc(router.query.id).get().then(ob => {
    const data = ob.data()
    ...
  })
}
現行
import { getFirestore, collection, doc, getDoc } from 'firebase/firestore'
import { useRouter } from 'next/router'

const router = useRouter()

if ( router.isReady && router.query.id !== undefined ) {
  const docRef = doc(db, 'mydata', router.query.id)
  getDoc(docRef).then(ob => {
    const data = ob.data()
    ...
  })
}
追加
書籍内
import firebase from 'firebase'

const db = {
  name: name,
  mail: mail,
  age: age
}

db.collection('mydata').add(ob).then(ref => {
  ...
})
現行
import { getFirestore, collection, addDoc } from "firebase/firestore"

const ob = {
  name: name,
  mail: mail,
  age: age
}

addDoc(collection(db, 'mydata'), ob).then(ref => {
  router.push('/fire')
})
削除
書籍内
import firebase from 'firebase'
import { useRouter } from 'next/router'

const router = useRouter()

db.collection('mydata').doc(router.query.id)
  .delete().then(ref => {
    ...
  })
現行
import { getFirestore, doc, getDoc } from 'firebase/firestore'
import { useRouter } from 'next/router'

const router = useRouter()

const docRef = doc(db, 'mydata', router.query.id)
deleteDoc(docRef).then(ref => {
  ...
})
検索
書籍内
import firebase from 'firebase'

// 検索対象の文字列
const name = '...'

// 完全一致
db.collection('mydata').where('name', '==', name).get()
  .then(snapshot => {
    snapshot.forEach((document) => {
      ...
    })
  })

// 前方一致
db.collection('mydata').orderBy('name').startAt(name).endAt(name + "\uf8ff")
  .then(snapshot => {
    snapshot.forEach((document) => {
      ...
    })
  })
現行
import { getFirestore, collection, query, where, orderBy, startAt, endAt, getDocs } from 'firebase/firestore/lite';

// 検索対象の文字列
const name = '...'

// 完全一致
const cols = collection(db, 'mydata')
const q = query(cols, where('name', '==', name))
getDocs(q).then(snapshot => {
  snapshot.forEach(document => {
    ...
  })
})


// 前方一致
const cols = collection(db, 'mydata')
const q = query(cols, orderBy('name'), startAt(name), endAt(name + "\uf8ff"))
getDocs(q).then(snapshot => {
  snapshot.forEach(document => {
    ...
  })
})
ちなみに startAt(name) endAt(name + "\uf8ff") は範囲指定を意味している。
\uf8ff はコードポイントの最大値であり、上記はnameに続く文字が 0x0000〜0xf8ff の範囲にあることを示している。
例えば name: hoge のとき、
- 先頭4文字が
hogeに一致し、 - 5文字目が
0x0000〜0xf8ffの範囲にある、つまり終端や全ての文字に一致する
という条件になるらしい。
Docker + SolrCloud
概要
以下の書籍の内容をベースにDocker + Solr8でSolrCloud環境を構築した。

構成
- ZooKeeper
- Solr
- Nginx
- 2つのSolrへリクエストを振り分けるLB
- 片方が死んでいる場合は生きている方に流す

コード
https://github.com/sota2502/japan_address
使用するデータ
郵便番号データダウンロード - 日本郵便 を使用した。 全都道府県で約12万件。 Shift-JIS → UTF-8 への変更とスキーマに合わせたヘッダーを追加している。
ZooKeeper
いきなりSolrCloudの構成を作る前にZooKeeperに慣れておくとよい。
docker-compose-zk.yml
version: '3.7'

x-zoo-service: &zoo-service
  image: zookeeper:3.5
  restart: always
  networks:
    - solr

services:
  zoo1:
    <<: *zoo-service
    container_name: zoo1
    hostname: zoo1
    ports:
      - 2181:2181
    env_file: ./zoo.env
    environment:
      ZOO_MY_ID: 1
    volumes:
      - ./data/zoo1/data:/data
      - ./data/zoo1/datalog:/datalog
  zoo2:
    <<: *zoo-service
    container_name: zoo2
    hostname: zoo2
    ports:
      - 2182:2181
    env_file: ./zoo.env
    environment:
      ZOO_MY_ID: 2
    volumes:
      - ./data/zoo2/data:/data
      - ./data/zoo2/datalog:/datalog
  zoo3:
    <<: *zoo-service
    container_name: zoo3
    hostname: zoo3
    ports:
      - 2183:2181
    env_file: ./zoo.env
    environment:
      ZOO_MY_ID: 3
    volumes:
      - ./data/zoo3/data:/data
      - ./data/zoo3/datalog:/datalog

networks:
  solr:
各々のZooKeeperのデータを永続化するため、/data,/datalog をVolumeにマウントする。これによりrestartなどをしてもデータは失われない。
ZooKeeperのクラスタを起動。
$ docker-compose -f docker-compose-zk.yml up -d
ZooKeeperのクライアントを用意する。Macであればhomebrewでインストールするのが簡単。
$ brew install zookeeper
zoo1 に接続してznodeを作成。
$ zkCli -server localhost:2181 create /hoge fuga
Connecting to localhost:2181

WATCHER::

WatchedEvent state:SyncConnected type:None path:null
Created /hoge
先ほど作ったznodeのデータを zoo2 から読み出す。
$ zkCli -server localhost:2182 get /hoge
Connecting to localhost:2182

WATCHER::

WatchedEvent state:SyncConnected type:None path:null
fuga
SolrのCollection用Configsetの作成
_default のConfigsetをベースに郵便番号を管理するためのConfigsetを作成する。これはCollectionを作るときに使う。
以下のコマンドを実行して、テンポラリなコンテナを作って、その中から _default Configsetsを取り出す。
$ docker create --name mysolr solr:8.5.2
$ docker cp mysolr:/opt/solr/server/solr/configsets/_default ./configsets
$ docker rm mysolr
この中で solrconfig.xml 、 schema.xml を編集していく。
特別なポイントはUUIDの設定をしているところ。 Solrのドキュメントを更新するためにはUniqueKeyが必要になる。しかし、郵便番号データにはUniqueKeyに適したものが存在しない。(同一の郵便番号の市町村が複数存在するケースがある) この制約はCSVを編集してIDを採番することでも満たすことは可能。 しかし、UUIDを採番するようにしておくほうが手間は省ける。
solrconfig.xml
差分は以下の通り。
38a39
>   <schemaFactory class="ClassicIndexSchemaFactory" />
1111c1112
<   <updateRequestProcessorChain name="add-unknown-fields-to-the-schema" default="${update.autoCreateFields:true}"
---
>   <updateRequestProcessorChain name="add-unknown-fields-to-the-schema" default="${update.autoCreateFields:false}"
1117a1119,1124
>   <updateRequestProcessorChain name="uuid" default="true">
>     <processor class="solr.UUIDUpdateProcessorFactory">
>       <str name="fieldName">uuid</str>
>     </processor>
>     <processor class="solr.RunUpdateProcessorFactory" />
>   </updateRequestProcessorChain>
<schemaFactory class="ClassicIndexSchemaFactory" /> は managed-schema の代わりに schema.xml を使用する場合に記述する。
add-unknown-fields-to-the-schema の UpdateRequestProcessorChain のdefault値をfalseにしておく。これはschemalessモードを使わないための設定。
uuid の UpdateRequestProcessorChain はUUIDを採番するための設定。
schema.xml
_default Configsetsには schema.xml は存在しない。
これは managed-schema を schema.xml にリネームして手動編集する。
差分は以下のようになる。これは郵便番号データに対応したfieldの定義の追加と、不要なfieldの定義の削除、UniqueKeyの変更をしている。
111a112,127
>     <field name="uuid" type="uuid" multiValued="false" indexed="true" required="true" stored="true"/>
>     <field name="jis" type="string" indexed="true" required="true" stored="true"/>
>     <field name="postcode" type="string" indexed="true" required="true" stored="true"/>
>     <field name="postcode5" type="string" indexed="true" required="true" stored="true"/>
>     <field name="prefecture_kana" type="text_ja" required="true"/>
>     <field name="city_kana" type="text_ja" required="true"/>
>     <field name="town_area_kana" type="text_ja" required="true"/>
>     <field name="prefecture" type="text_ja" indexed="true" required="true" stored="true"/>
>     <field name="city" type="text_ja" indexed="true" required="true" stored="true"/>
>     <field name="town_area" type="text_ja" indexed="true" required="true" stored="true"/>
>     <field name="is_one_town_by_multi_postcode" type="boolean" required="true"/>
>     <field name="is_need_small_area_address" type="boolean" required="true"/>
>     <field name="is_chome" type="boolean" required="true"/>
>     <field name="is_multi_town_by_one_postcode" type="boolean" required="true"/>
>     <field name="updated" type="boolean" required="true"/>
>     <field name="update_reason" type="boolean" required="true"/>
113d128
<     <field name="id" type="string" indexed="true" stored="true" required="true" multiValued="false" />
117,122d131
<     <!-- If you don't use child/nested documents, then you should remove the next two fields:  -->
<     <!-- for nested documents (minimal; points to root document) -->
<     <field name="_root_" type="string" indexed="true" stored="false" docValues="false" />
<     <!-- for nested documents (relationship tracking) -->
<     <field name="_nest_path_" type="_nest_path_" /><fieldType name="_nest_path_" class="solr.NestPathField" />
<
169c178
<     <uniqueKey>id</uniqueKey>
---
>     <uniqueKey>uuid</uniqueKey>
1012a1022,1023
>     <fieldType name="uuid" class="solr.UUIDField" indexed="true" />
>
1023d1033
<
SolrCloud環境の構築
docker-compose で ZooKeeper 、 Solr 、 Nginx のSolrCloud環境を構築する。
docker-compose
docker-compose.yml やその他に必要なファイルは以下のようになる。
docker-compose.yml
version: '3.7'

x-zoo-service: &zoo-service
  image: zookeeper:3.5
  restart: always
  networks:
    - solr

x-solr-service: &solr-service
  image: solr:8.5.2
  environment:
    ZK_HOST: zoo1:2181,zoo2:2181,zoo3:2181
    SOLR_JAVA_MEM: -Xms1g -Xmx1g -Xmn512m
  networks:
    - solr
  depends_on:
    - zoo1
    - zoo2
    - zoo3

services:
  zoo1:
    <<: *zoo-service
    container_name: zoo1
    hostname: zoo1
    env_file: ./zoo.env
    environment:
      ZOO_MY_ID: 1
    volumes:
      - ./data/zoo1/data:/data
      - ./data/zoo1/datalog:/datalog
  zoo2:
    <<: *zoo-service
    container_name: zoo2
    hostname: zoo2
    env_file: ./zoo.env
    environment:
      ZOO_MY_ID: 2
    volumes:
      - ./data/zoo2/data:/data
      - ./data/zoo2/datalog:/datalog
  zoo3:
    <<: *zoo-service
    container_name: zoo3
    hostname: zoo3
    env_file: ./zoo.env
    environment:
      ZOO_MY_ID: 3
    volumes:
      - ./data/zoo3/data:/data
      - ./data/zoo3/datalog:/datalog
  solr1:
    <<: *solr-service
    container_name: solr1
    volumes:
      - ./data/solr1:/var/solr
  solr2:
    <<: *solr-service
    container_name: solr2
    volumes:
      - ./data/solr2:/var/solr
  nginx:
    image: nginx:1.19.2
    container_name: nginx
    volumes:
      - ./nginx.conf:/etc/nginx/nginx.conf:ro
    ports:
      - 8080:80
    networks:
      - solr
    depends_on:
      - solr1
      - solr2

networks:
  solr:
Solrのデータを永続化するために /var/solr をVolumeにマウントする。
zoo.env
ZOO_SERVERS=server.1=zoo1:2888:3888;2181 server.2=zoo2:2888:3888;2181 server.3=zoo3:2888:3888;2181
ZOO_4LW_COMMANDS_WHITELIST=mntr,conf,ruok
nginx.conf
user nginx;
worker_processes  auto;

error_log /var/log/nginx/error.log warn;
pid       /var/run/nginx.pid;

events {
  worker_connections  1024;
}

http {
  upstream solr {
    server solr1:8983;
    server solr2:8983;
  }

  server {
    listen 80;
    client_max_body_size 20M;

    location / {
      proxy_pass http://solr;
    }
  }
}
コンテナを起動。
$ docker-compose up -d
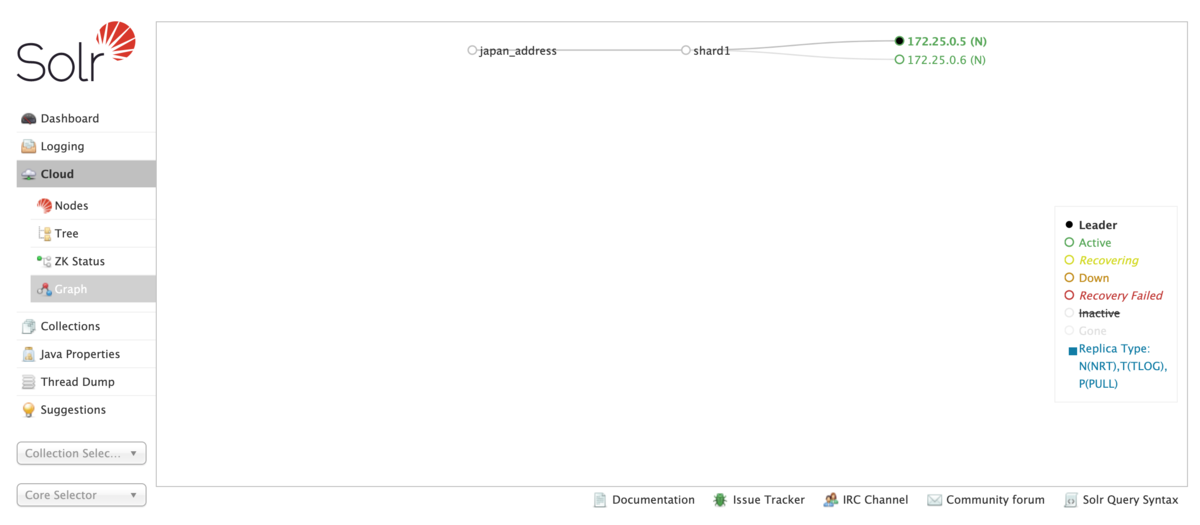
起動が完了したら http://localhost:8080/solr/ にブラウザでアクセスする。SolrのWeb管理画面が表示される。 Cloud → Graph でSolrノードの繋がりが見える。
ConfigsetsのUpload
[SolrのCollection用Configsetの作成] で作ったConfigsetsをアップロードする。 これは一度zipで一つにしたものをAPIで送る。
$ cd configsets/conf
$ zip -r japan_address.zip *
$ curl -X POST --header "Content-Type:application/octet-stream" \
  --data-binary @japan_address.zip \
  "http://localhost:8080/solr/admin/configs?action=UPLOAD&name=japan_address"
ZooKeeperコンテナに対して2181ポートをマッピングしておいて、 zkCli で ls コマンドを実行するとConfigsetsに対するznodeができているのが確認できる。
(上記のdocker-compose.ymlではポートをマッピングしていないので、これを行う場合には ports の記述を追加する必要がある)
$ zkCli -server localhost:2181 ls /configsets
Collectionの作成
http://localhost:8080/solr/#/~collections:Solr管理コンソール からCollectionを作成する。 今回はシャード1、レプリカ2なので以下のように入力する。
| 項目 | 値 |
|---|---|
| name | japan_address |
| configset | japan_address |
| numShards | 1 |
| replicationFactor | 2 |
Add Collection をクリックして画面をリロードするとCollectionが作成されたのが確認できる。
CSVデータのインポート
以下のコマンドを実行してCSVデータをインポートする。これは結構時間がかかる。
$ curl -H 'Content-type: text/csv; charset=utf-8' \
  --data-binary @ken_all.csv \
  'http://localhost:8080/solr/japan_address/update?commit=true'
検索の実行
Curlコマンドか Solr管理画面 でクエリを実行すると結果が返ってくるのが見える。
$ curl 'http://localhost:8080/solr/japan_address/select?q=*:*'
フェールオーバーの確認
現在は2つのSolrにNginxがリクエストを振り分けている状態。 ここから片方のSolrが落ちた状態でもリクエストを処理していることを確認する。
以下のコマンドで solr2 のコンテナを停止させる。
$ docker-compose stop solr2
Solr管理画面のCloud → Tree で片方が停止しているのが把握できる。
Curlで何回かクエリを実行して、いずれもレスポンスが返ってきているのが確認できる。
WWW::Curl::Easyでファイルをアップロード
目的
WWW::Curl::EasyでファイルをPOSTでアップロードしたい。 ただし、ファイルは巨大になるケースを想定して、一旦メモリに読み込むのを避けたい。
コード
use strict;
use warnings;

use WWW::Curl::Easy;

my $file = 'hoge.csv';
my $size = -s $file;

open my $fh, '<', $file or die 'Cannot open file';
my $url = 'http://example.com/sample';

my @headers = (
    "Content-type: text/csv; charset=utf8"
);

my $curl = WWW::Curl::Easy->new();
$curl->setopt(CURLOPT_POST, 1);
$curl->setopt(CURLOPT_URL, $url);
$curl->setopt(CURLOPT_POSTFIELDSIZE_LARGE, $size);
$curl->setopt(CURLOPT_READDATA, \$fh);
$curl->setopt(CURLOPT_HTTPHEADER, \@headers);

if ( $curl->perform != 0) {
    die 'fail to upload';
}

my $code = $curl->getinfo(CURLINFO_HTTP_CODE);
print "Code: $code";

close $fh;
参考
https://stackoverflow.com/questions/9485157/wwwcurl-how-to-upload-post-large-files
YAPC::Tokyo 2019 に参加した感想
とりあえず雑でも感想を書いておく。後にすると絶対書かない。
メッセージングのプロトコル
https://speakerdeck.com/lyokato/yapc-japan-tokyo-2019-metusezingufalsepurotokoru
- 発表後の本人のMediumのエントリ を読むと発表の意図がわかりやすい。確かに、特定の技術に対して安易にマイナスなイメージをつけないようにされていて、その点はすごくよかった。
- どうすれば標準化がうまくいって広まったんだろう?慎重になりすぎてたんだろうか?
- スライドの文字が小さくて読みづらく、マイクが離れていたので聞きづらかったので、情報を得るのがしんどかった。。
ランチセッション Garuda:汎用コネクティビティ プラットフォーム Perlをサイエンスの世界につなぐ
- 創薬はすごい手間も時間もかかるし、そこに非エンジニアのリソースをバンバン投入したいので、そういうところで重宝されるんだろうな。そういった用途で非エンジニア向けにはすごく需要高そう。
ランチセッション 20歳の僕が経験したPerlエンジニアへの道
- 「やりたい」「やりたくない」だけで選ばず、やることによる理由をポジティブに捉えてるのがよかった。
- 知らない言語の現場に放り込まれるというのはきっとあるだろうし、自分の学習プロセスを構築するのにはいい経験。
綱渡りバッチ脱出大作戦
https://speakerdeck.com/shinpeim/gang-du-ribatutituo-chu-da-zuo-zhan
- 直近で全cronサーバーの入れ替えのため、全バッチが何をやってどういう挙動をしているかを調査しないといけなかったので、苦労にものすごく共感した。。
- 成否やスケジューリングの管理をしたくてRundeckとか試してたけど、前者だけならhorensoだけで良さそう。後者に関しては冗長化の観点をすっぽり抜けていて「確かに」と思った。
- 前職もそうだったけど、過度にcronに依存するシステムはつらい。。
- プレゼンが聞きやすかった。
Wazuhを利用した大統一サーバ監査基盤
https://speakerdeck.com/pyama86/wazuhwoli-yong-sita-da-tong-sabajian-cha-ji-pan
- セキュリティインシデントの調査は本当にすごく手間だし時間もかかるよね。。
- またToB要件で顧客情報を扱うケースに遭遇したら入れておきたい
エンジニアリング組織論への招待 -2つのDXと技術的負債-
https://speakerdeck.com/hirokidaichi/2tufalsedxtoji-shu-de-fu-zhai-yapc-tokyo-2019
Perlでも分散トレーシングしたい!AWS::XRay による解析とその実装
https://speakerdeck.com/fujiwara3/yapc-tokyo-2019
- 新規でPerlでサービス作って、マイクロサービスを進めるときには使いたい。
- 今担当しているサービスはモノリスで、ここからマイクロサービスに切り分けてくこともないので、Devel::KYTProfで十分そう。
Dive into MySQL Error
https://speakerdeck.com/yoku0825/dive-into-mysql-error-yapc-tokyobaziyon
Erlangことはじめ
Erlangことはじめ
erlangを書くことになったので、初歩的なスクリプトの実行からテストの実行までを勉強。
ディレクトリ構成
myproject
├── ebin
│   └── mymath.beam    # コンパイル時に生成される
├── rebar
├── src
│   └── mymath.erl
└── test
    └── mymath_test.erl
rebarを持ってくる
Erlangのビルドツールであるrebarを持ってくる。コンパイルやテスト実行が簡単になる。
git clone https://github.com/rebar/rebar.git
cd rebar
make
コードを書く
フィボナッチ数、階乗を返す関数を定義したモジュールを書く。
src/mymath.erl
-module(mymath).
-export([fib/1, fact/1]).

fib(X) when X < 0 ->
    throw({error, 'Negative Number'});
fib(0) ->
    1;
fib(1) ->
    1;
fib(X) ->
    fib(X - 1) + fib(X - 2).

fact(X) when X < 0 ->
    throw({error, 'Negative Number'});
fact(0) ->
    0;
fact(1) ->
    1;
fact(X) ->
    X * fact(X - 1).
試しに実行してみる。
$ rebar compile
$ erl -pa ebin
Erlang/OTP 17 [erts-6.4] [source] [64-bit] [async-threads:10] [hipe] [kernel-poll:false]

Eshell V6.4  (abort with ^G)
1> mymath:fib(3).
3
2> mymath:fact(3).
6
テストを書く
mymath.erlに対する単体テストを書く。 テストのファイルはmymath_test.erlになる。 テストでは*_testのメソッドが呼ばれる。
test/mymath_test.erl
-module(mymath_test).
-include_lib("eunit/include/eunit.hrl").

fib_test() ->
    ?assertThrow({error, 'Negative Number'}, mymath:fib(-1)),
    ?assertEqual(1, mymath:fib(0)),
    ?assertEqual(1, mymath:fib(1)),
    ?assertEqual(2, mymath:fib(2)),
    ?assertEqual(3, mymath:fib(3)),
    ?assertEqual(5, mymath:fib(4)).

fact_test() ->
    ?assertThrow({error, 'Negative Number'}, mymath:fact(-1)),
    ?assertEqual(0, mymath:fact(0)),
    ?assertEqual(1, mymath:fact(1)),
    ?assertEqual(2, mymath:fact(2)),
    ?assertEqual(6, mymath:fact(3)),
    ?assertEqual(24, mymath:fact(4)).
テストを実行する
テストを実行してテストが通るか確かめる。
$ ./rebar eunit
==> myproject (eunit)
  All 3 tests passed.
